低调六年,一鸣惊人!中国博通炸场
看!这匹高性能互连芯片黑马
算力竞赛的下半场,瓶颈不只在芯片,也在芯片之间。
大模型的发展,正在从单一预训练走向训练与推理协同,对计算、存储和网络的要求随之提高。尤其是在大规模 AI 集群中,多个计算节点需要频繁交换模型参数、梯度等数据,通信与同步开销会侵蚀理论算力。随着集群规模扩大,如何减少数据传输等待、提高有效算力利用率,成为算力基础设施建设必须解决的问题。
这让高性能互连从过去的配套环节,走到了算力基础设施竞争的前台。尤其在大规模AI集群中,互连芯片不仅影响数据传输效率,也关系到集群的扩展能力与整体运行效率。算力继续增长,互连技术也必须同步升级。
全球市场已经形成了成熟的产业格局。以博通为代表的芯片企业,凭借在高速交换、网络互连等领域的长期积累,深度参与全球数据中心基础设施建设。
对于中国芯片企业而言,高性能互连需求增长带来了新的市场空间,但要切入这一市场,难点并不只是做出一颗颗芯片,而是能否覆盖不同场景的互连需求,并将产品真正嵌入复杂的算力系统。
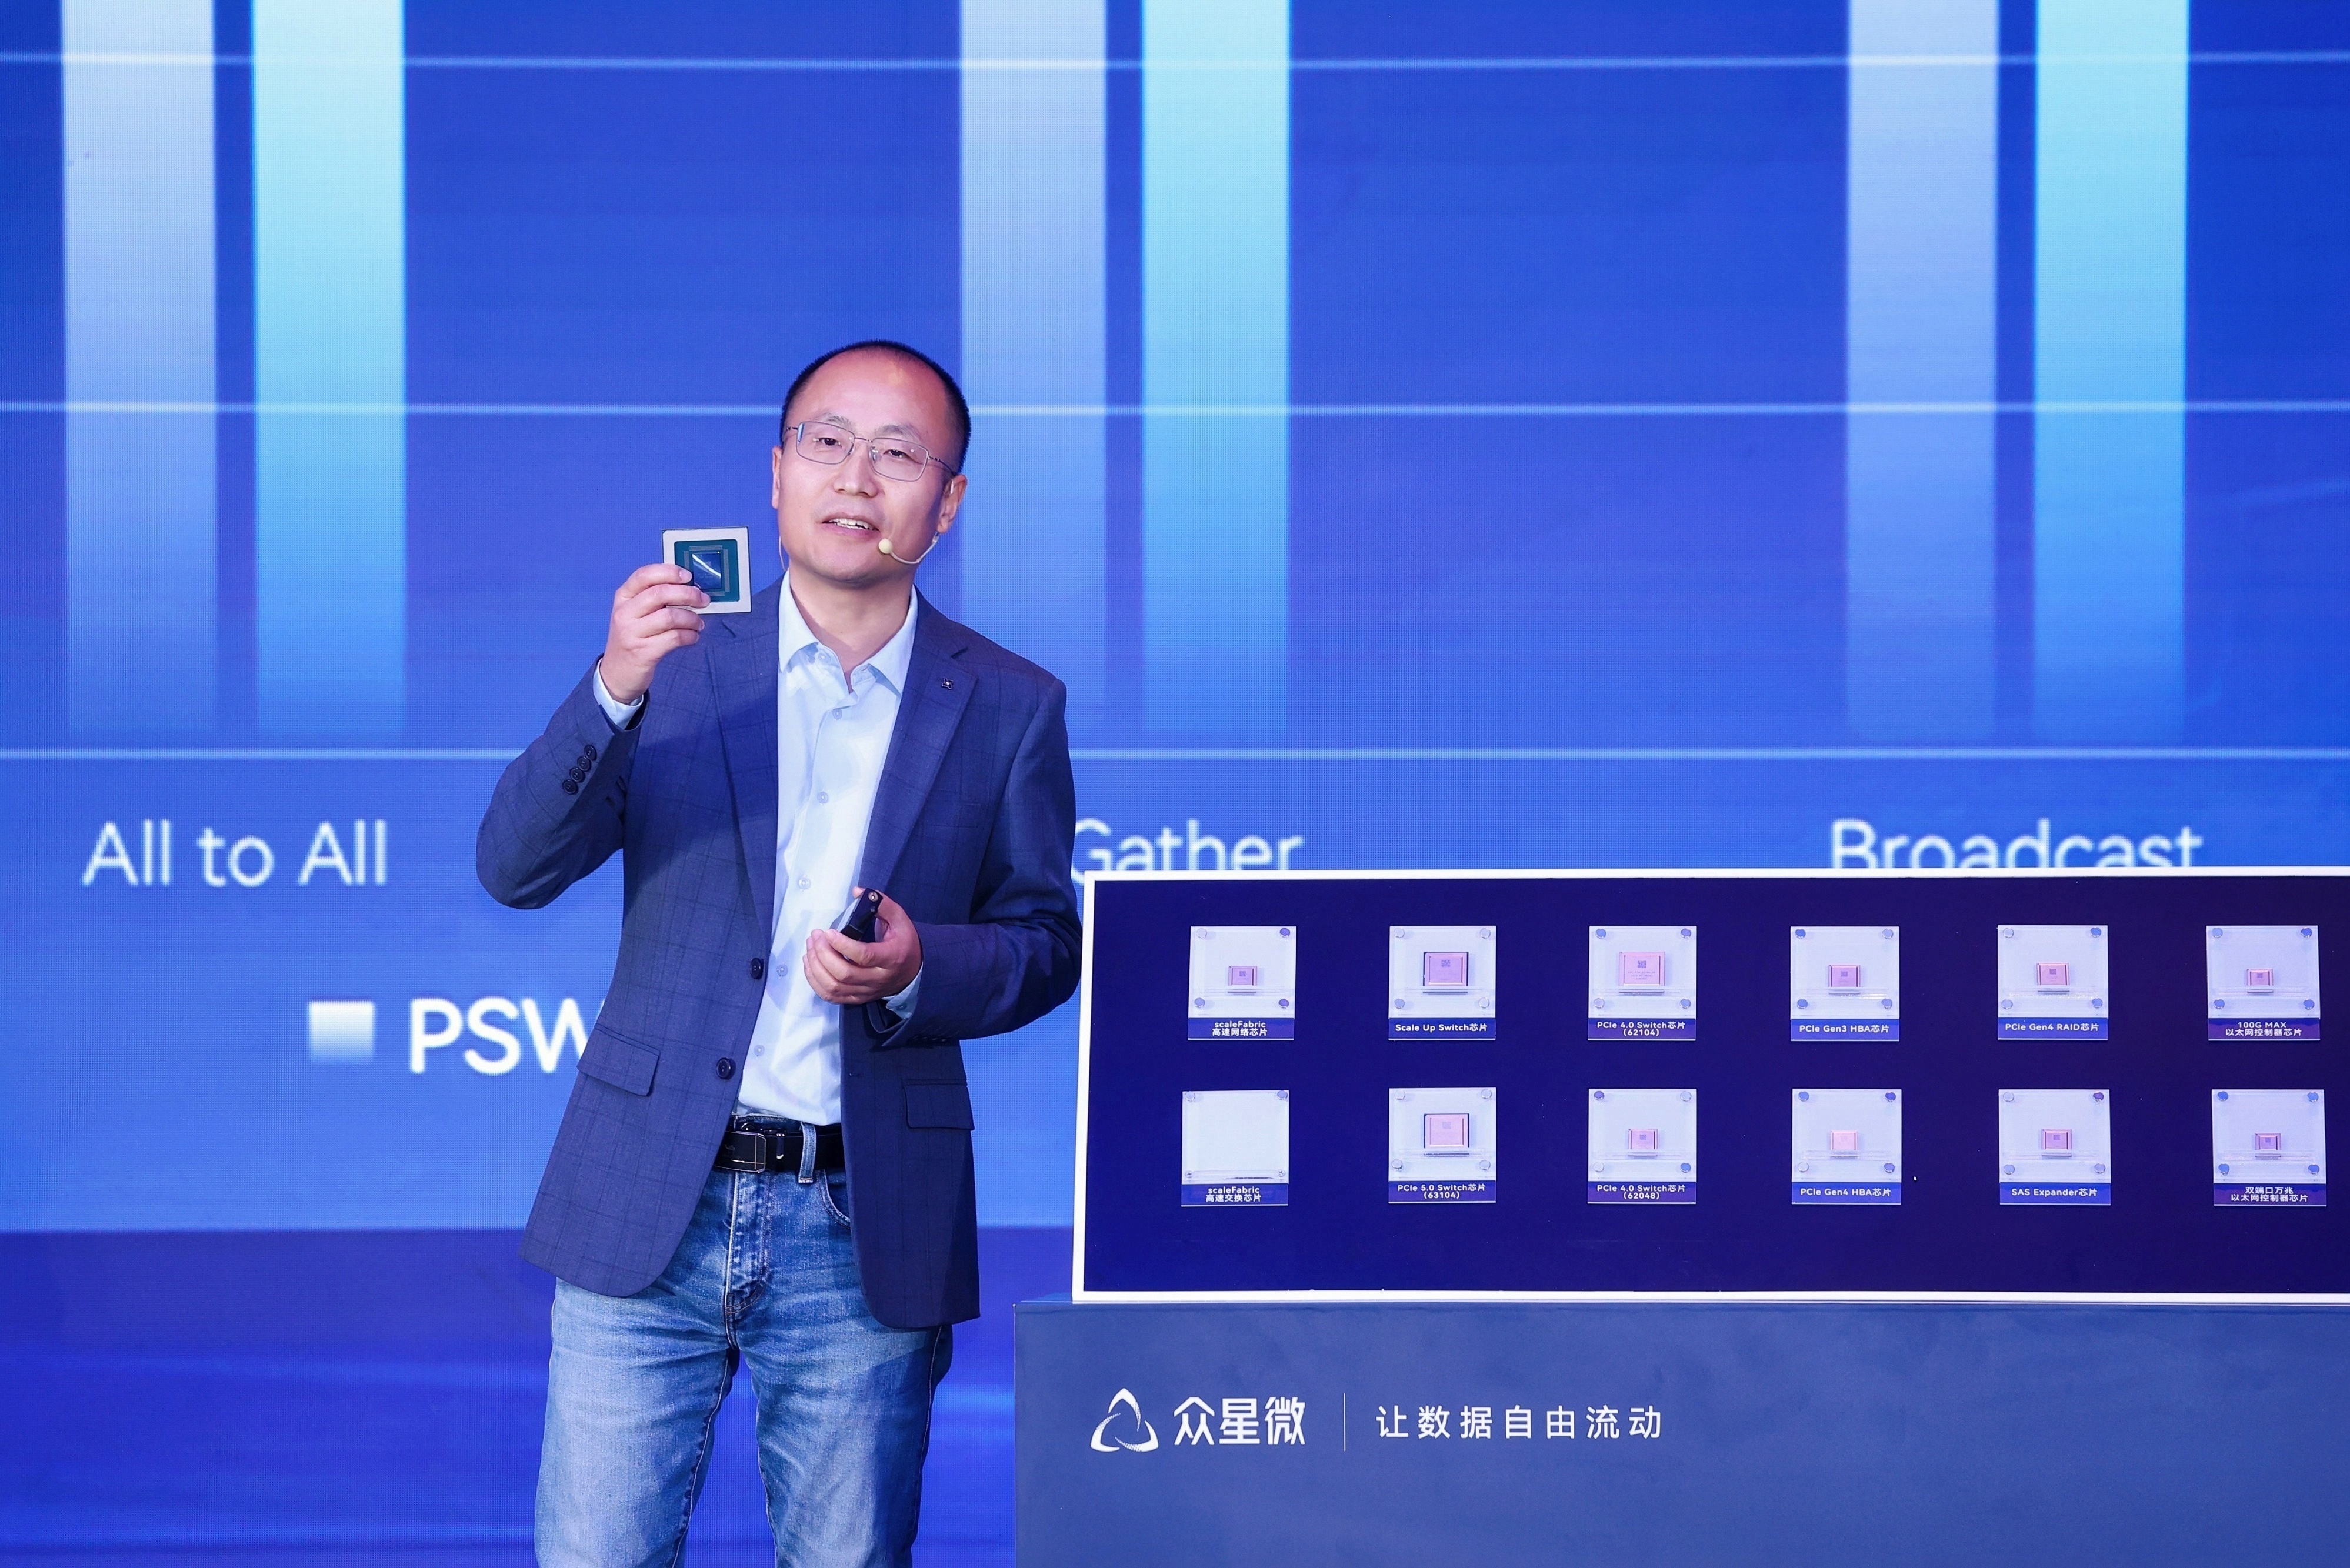
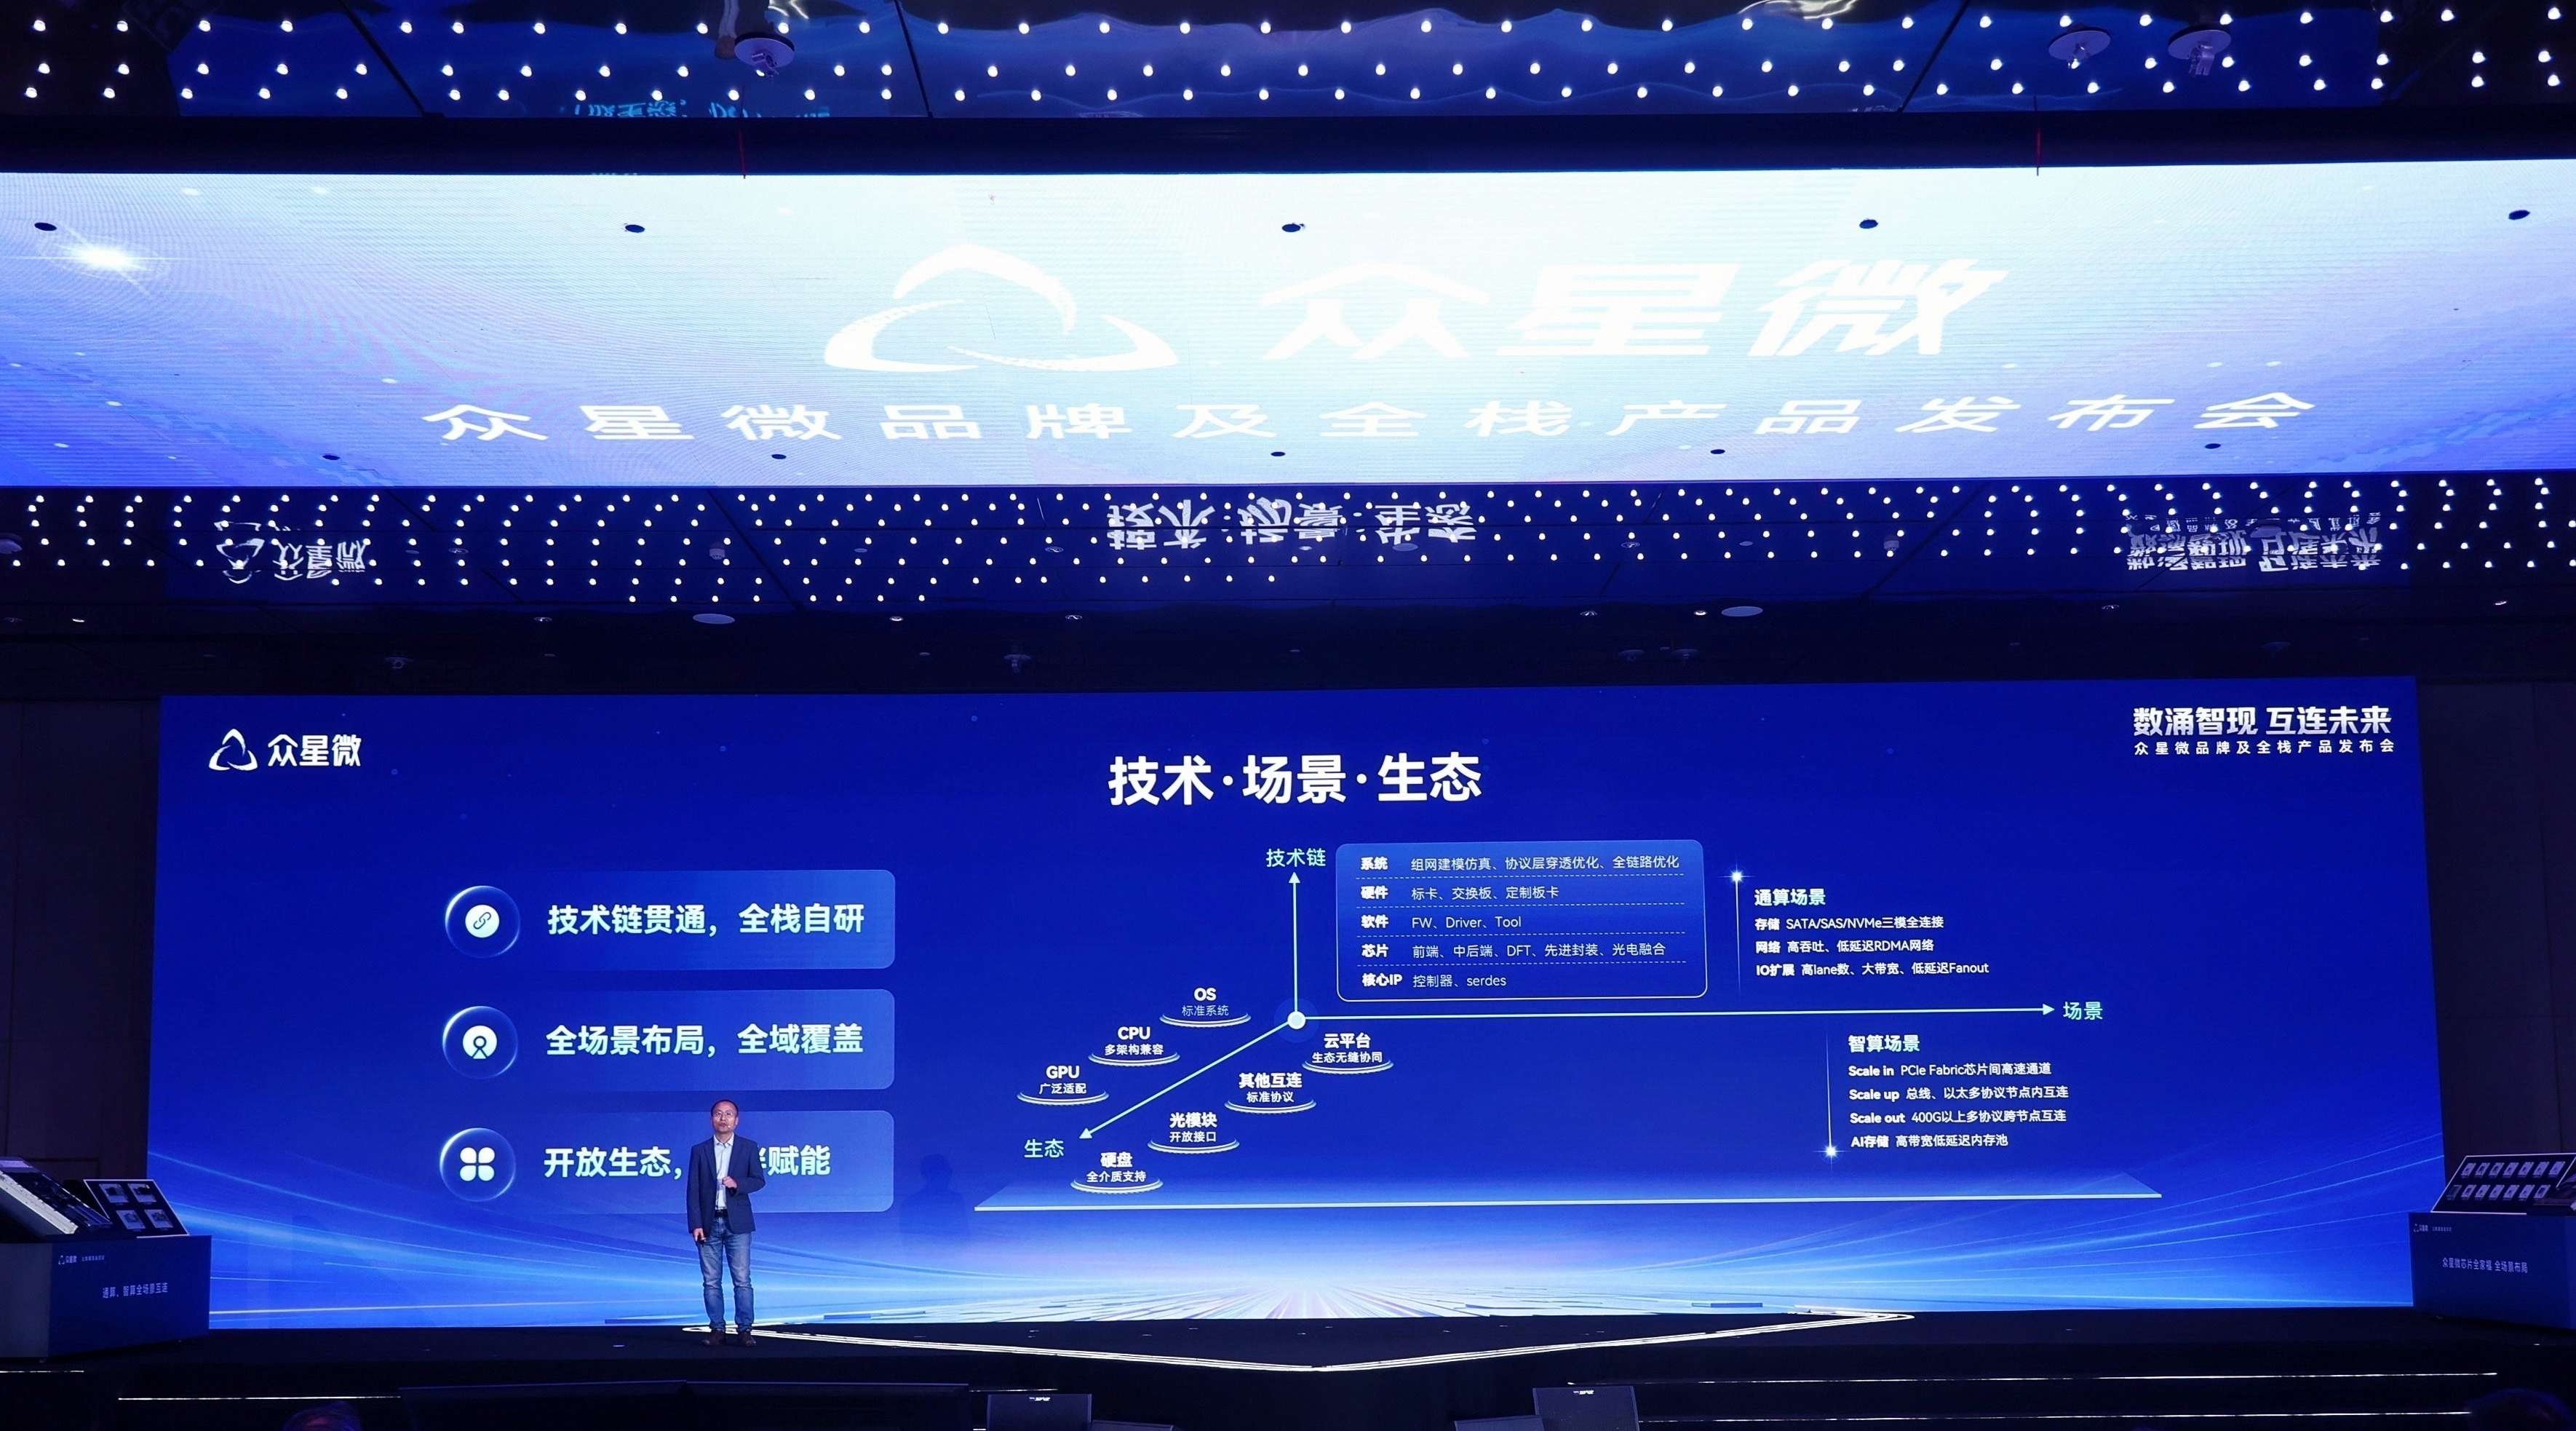
众星微选择的,正是一条多品类、全栈式的技术路线。10月15日,众星微在无锡举办品牌及全栈产品发布会,并集中发布PCIe 6.0 Switch、800G多协议AI NIC及多模RAID芯片三款新品,进一步向高速计算互连、AI集群网络和企业级存储拓展。
从这个角度看,众星微的布局不只是增加几条产品线,而是尝试以更完整的互连产品体系,承接AI算力基础设施升级带来的需求。
互连即效能,众星微向“中国博通”迈进
在AI算力基础设施中,互连的价值不仅在于提高传输速度,更在于让不同硬件之间实现高效协同。
“高性能互连芯片如同基础设施的‘骨架’,把分布的计算单元连成一台可扩展的超级大脑。”众星微总经理郭二辉认为,当算力规模从单卡走向万卡/十万卡集群,互连的高带宽与低延迟,成为支撑系统性能和稳定性最重要因素。
众星微提出了一个衡量集群运行效率的公式:集群有效算力=单点算力×规模×互连效率。其核心逻辑是,芯片的理论算力并不等于系统的实际产出,互连效率会影响计算资源的利用率,进而影响整个集群的运行表现。
以大模型训练中的有效算力利用率为例,通信同步、重计算和 I/O 等待等因素,都会造成理论算力与实际算力之间的差距。互连并不能解决所有效率损耗,但通信开销是其中重要且有机会通过工程优化改善的一环。以某大模型训练实际数据为例,测算通信占比缩短 10% 后,训练时间可减少约 1.3 天,并节省约 0.3 亿元成本。
这一逻辑也解释了为何高性能互连成为全球芯片巨头持续投入的方向。博通便是其中的代表。凭借在高速以太网交换、SerDes等领域的技术积累,博通深度参与云计算厂商的定制AI芯片和数据中心网络建设。2025财年,博通AI半导体业务收入约200亿美元,同比增长65%。随着AI集群规模扩大,网络交换芯片等产品成为其AI业务增长的重要组成部分。
博通的竞争力并非来自某一款芯片,而是长期积累的高速接口技术、交换架构与客户生态。众星微走的也是这条路线,围绕存储互连、网络互连和AI互连展开布局,覆盖通用计算与智能计算场景。
目前,众星微已形成覆盖存储互连、网络互连、IO扩展及智能计算互连的产品体系,12款国产高性能互连芯片和系列核心IP集中亮相,累计出货超过80万颗。与聚焦单一接口或产品的厂商相比,其布局更强调不同产品之间的协同,以及从芯片到系统的整体适配能力。
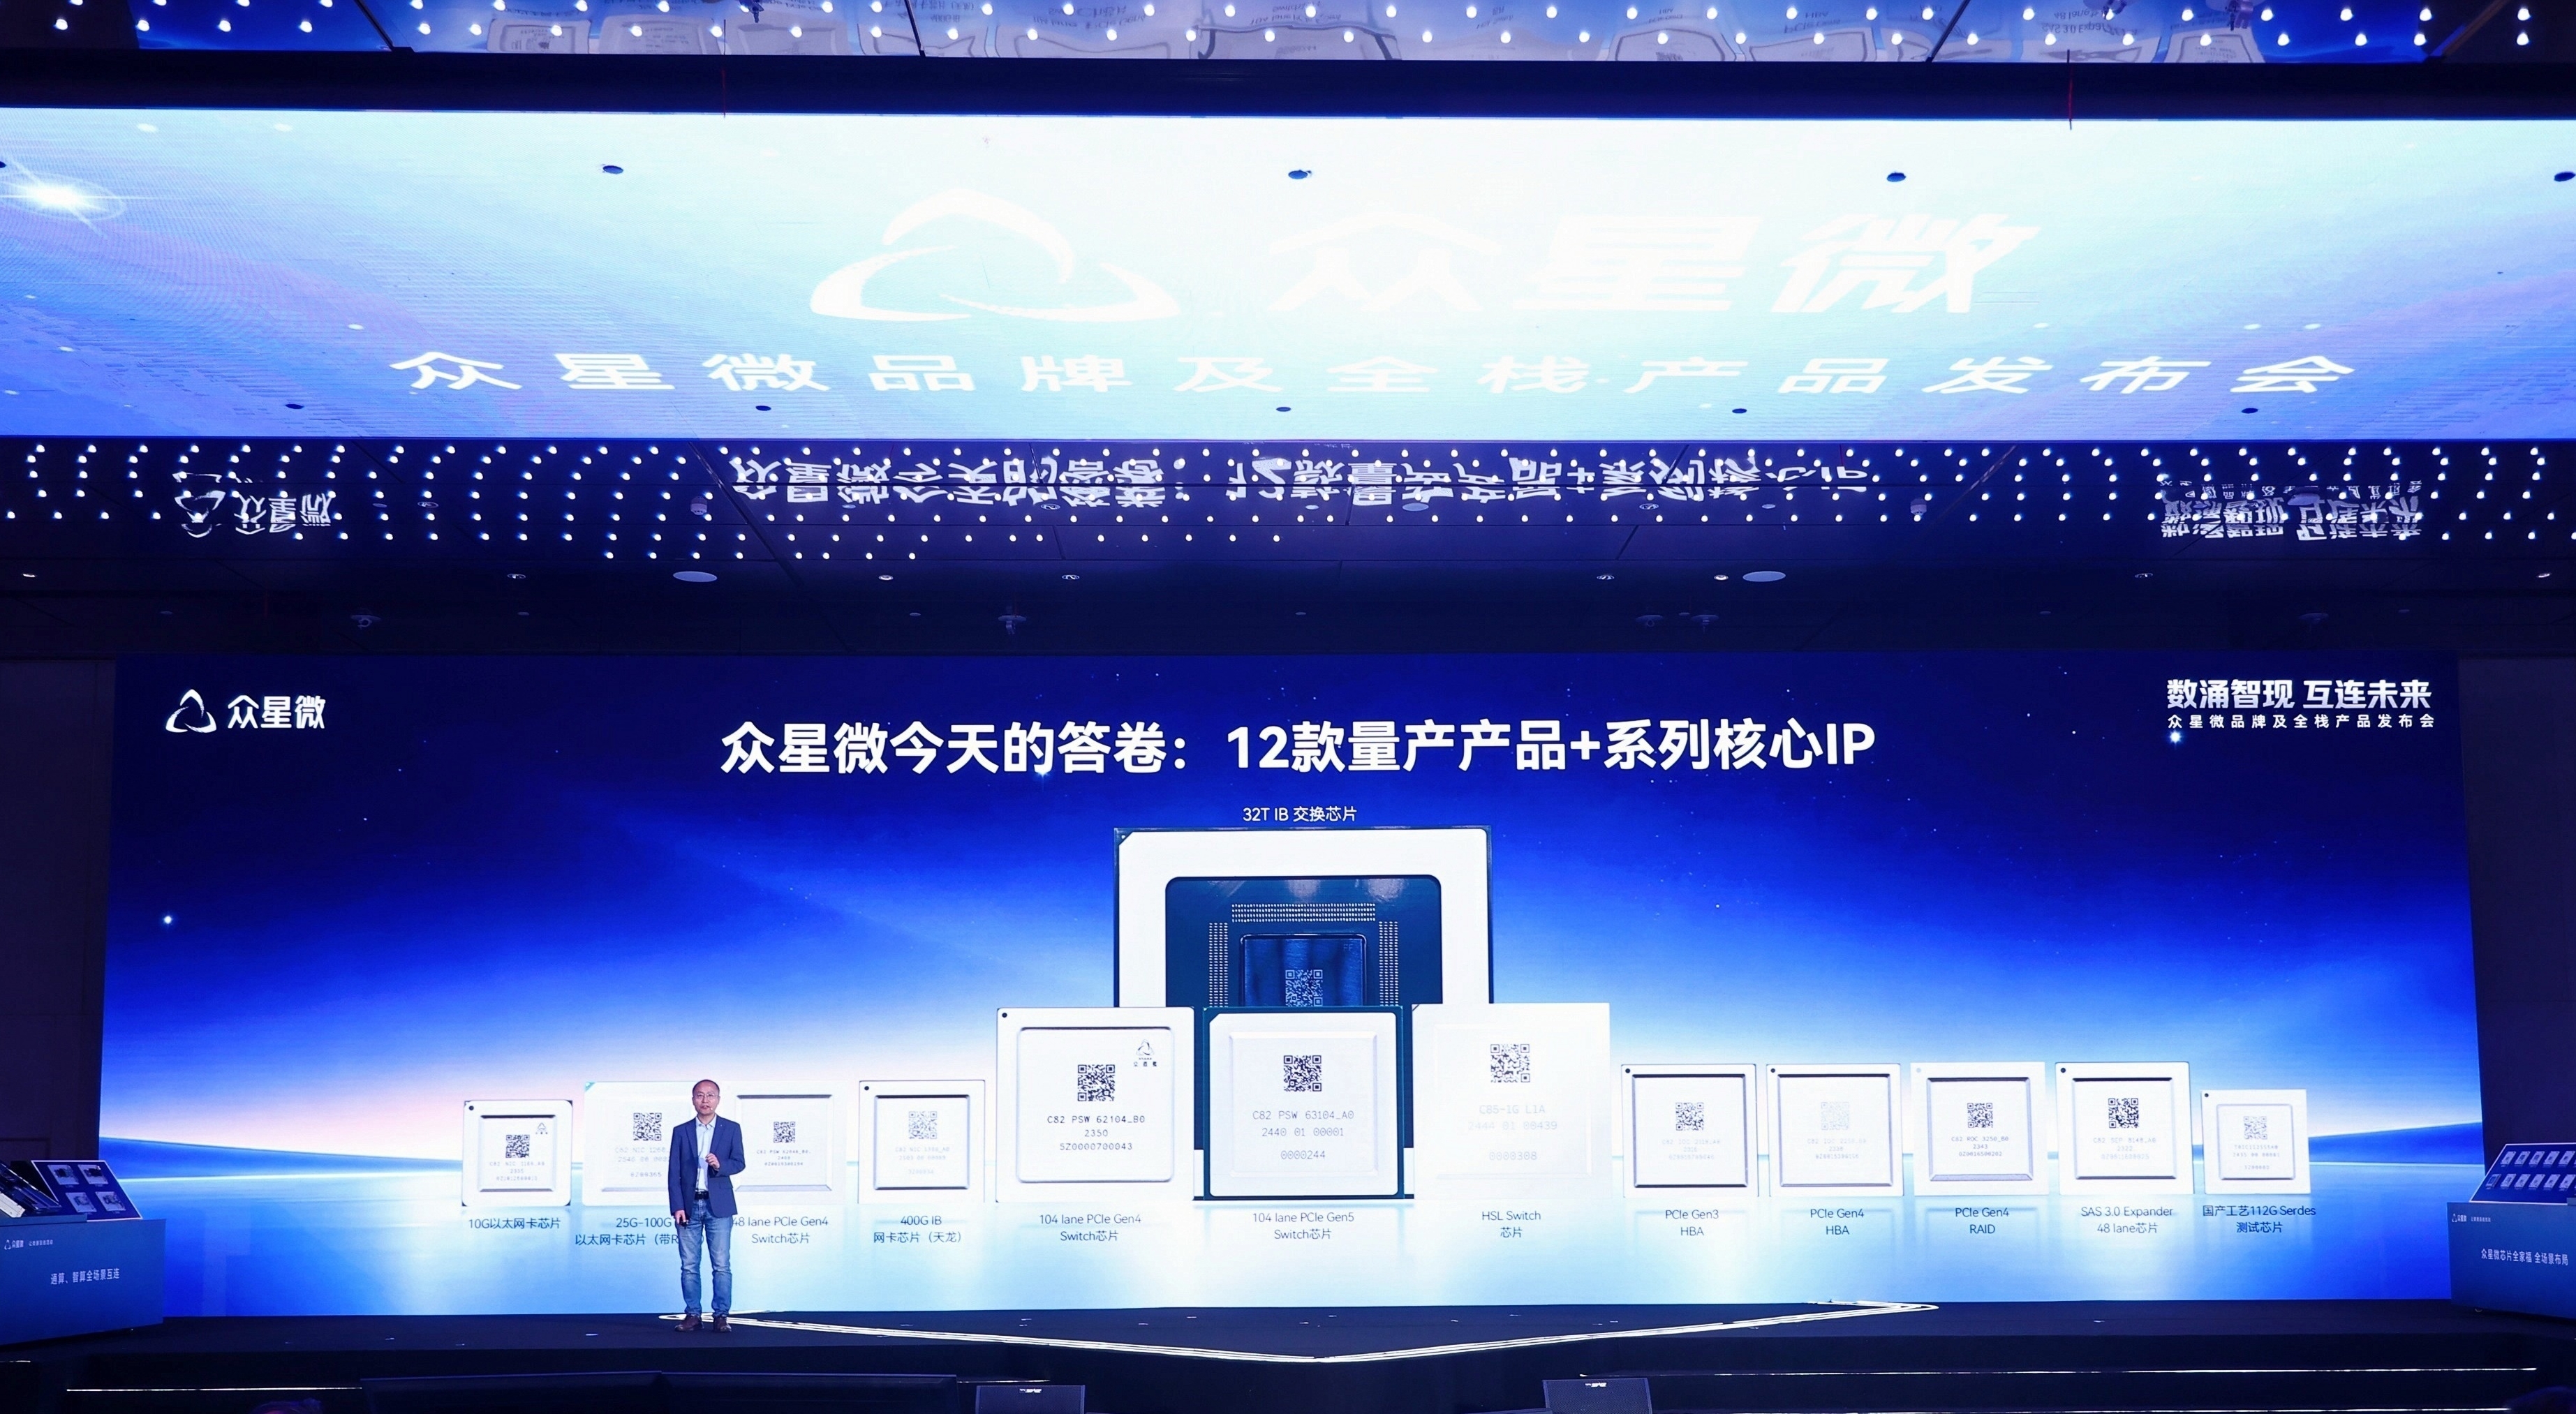
这一路线对研发体系提出了更高要求。众星微拥有千余名研发人员,技术人员占比超过90%,并在全国布局8个研发中心。
研发资源的持续投入,也成功转化为产品性能与应用能力。此次推出的三款新品,分别覆盖高速互连、AI集群通信和高性能存储。其中,PCIe 6.0 Switch最多支持144条通道,带宽较Gen5翻倍;800G多协议AI NIC支持800G线速传输及微秒级时延,面向大规模AI集群提供高速通信能力;多模RAID芯片支持SAS、SATA及PCIe 5.0三模连接,内置加密引擎,兼顾存储性能与数据安全。
据悉,在现有产品基础上,众星微还在布局光连接、高速SerDes及存储池化等关键技术,进一步拓展面向下一代算力基础设施的产品能力。
随着AI集群规模持续扩大,互连芯片在算力基础设施中的价值也日益凸显。据相关数据,英伟达Vera Rubin NVL72机柜中,互连芯片的价值占比达到9%,高于上一代GB300 NVL72的8%。国内互连芯片市场同样拥有广阔的增长空间,市场规模有望达到千亿元级别。
全场景产品布局,共建互连生态
随着互连覆盖芯粒、服务器、机架、集群及跨数据中心等多个层级,产业竞争也进一步延伸到标准与生态。
协议、芯片、软件、参考设计、测试认证和客户应用共同构成互连生态,决定不同硬件能否高效协同、组成系统。面向下一阶段AI发展,互连技术的持续创新与生态协作,将成为提升算力系统整体能力的重要支撑。
众星微的思路是从系统需求出发,向下拆解至部件、芯片和核心 IP,再通过软件、固件及系统级验证形成闭环。以网络互连为例,产品不仅需要满足芯片本身的带宽和时延指标,还需要在协议、拥塞管理、链路损耗和异常故障等条件下接受验证。这意味着,全栈研发并不只是将更多产品纳入同一张产品目录,而是要让不同层级的产品在统一的系统目标下协同设计、协同验证。
众星微所在的无锡,为这一切提供了便利。无锡是中国集成电路产业的重要发源地之一。自1986年诞生国内第一块6英寸集成电路以来,经过近40年发展,无锡已形成涵盖芯片设计、晶圆制造、封装测试、半导体装备及关键材料的产业链,集聚了数百家相关企业。
从产业分工看,无锡既有SK海力士、华虹、华润微、卓胜微等芯片制造企业,也有盛合晶微、长电科技等企业持续布局先进封装,还有微导纳米等企业深耕半导体设备。不同环节的企业集聚,为芯片研发、制造验证及产业协作提供了基础。
对于高性能互连芯片企业而言,产业集群的价值不只在于供应链配套,也在于人才、技术和产业资源的持续汇聚。互连芯片研发周期长、系统适配复杂,从产品设计到客户验证,再到规模化部署,需要研发团队、上下游伙伴与终端客户共同参与。
在技术实现上,众星微强调贯通系统架构、核心IP、芯片、软件与运维的全链路研发能力,通过统一网络架构、RDMA协议与拥塞管理规则,减少不同技术模块之间的割裂,提升系统协同效率。同时,公司通过端到端闭环验证与运维环境,确保技术方案从系统设计到具体部件、芯片和软件的逐层分解与落地,并支持SoC、关键模块、固件及算法的深度定制。
在互联网领域,众星微基于软硬件全栈自研的HBA与Expander产品,提供高密存储整机、存算分离架构及系统级交付方案,满足互联网客户的定制化需求。在运营商领域,其HBA、网卡产品已应用于“三朵云”、服务器集采及网安中心等项目,累计部署近10万片,在移动网络云内场和外场环境中稳定运行超过18个月。
在金融领域,基于RAID产品构建的存储架构可满足微秒级延迟、百万级IOPS并发处理需求。依托全栈国产化能力,相关产品已实现规模化部署,累计超过5万片。在电力能源领域,基于RAID卡、网卡实现安全可控云管平台私有化部署和公有云集中调度,已有超2万片产品稳定运行在电力能源行业关键监控和资源调度系统。
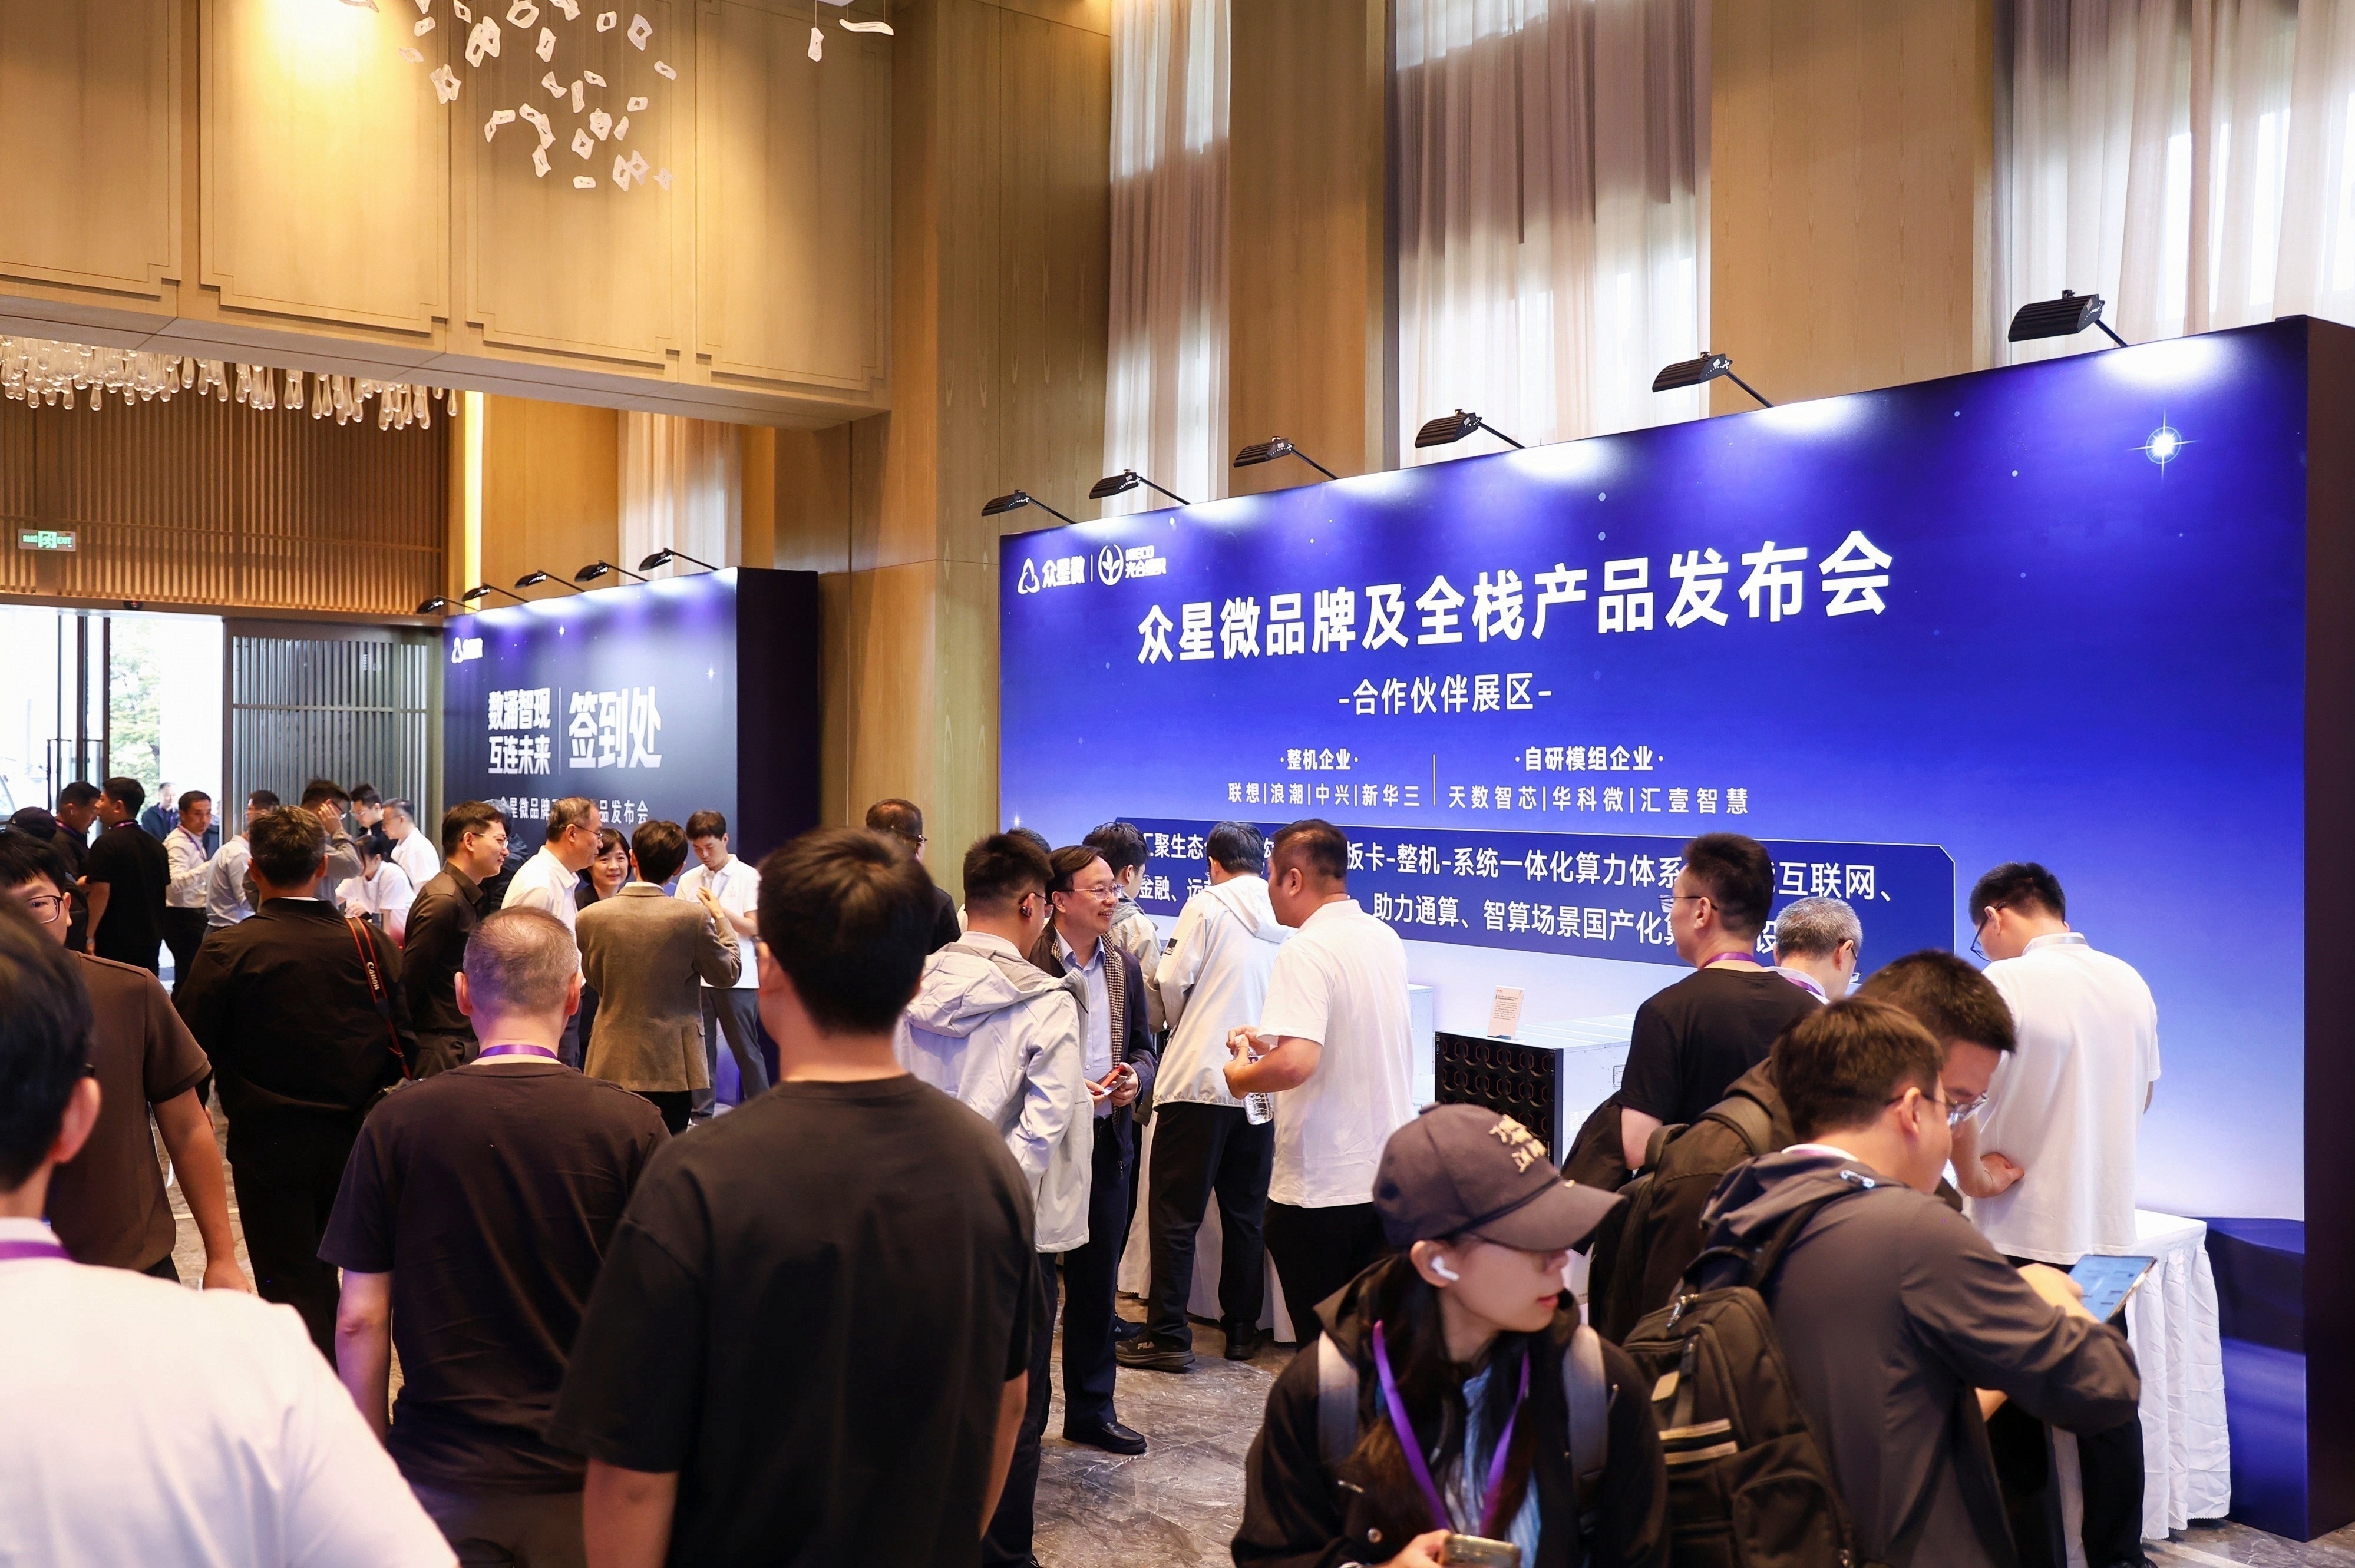
事实上,众星微产品已进入浪潮、中兴通讯、新华三、联想等企业的产品与解决方案体系,在互联网、金融、运营商及人工智能等领域实现规模部署。与此同时,众星微已完成七大主流CPU平台适配,并与七大主流CPU平台、15+主流算力芯片、15+主流云平台、50+操作系统、300+硬盘与光模块伙伴开展合作,持续拓展国产高性能互连的应用生态。
未来,谁掌握互连,谁就掌握集群的边际成本与扩张上限。从核心技术到产品矩阵,再到系统适配,众星微正通过高性能架构、可靠性设计与全栈自研能力,持续完善高性能互连布局,向“中国博通”的目标迈进。
本网站上的内容(包括但不限于文字、图片及音视频),除转载外,均为时代在线版权所有,未经书面协议授权,禁止转载、链接、转贴或以其他 方式使用。违反上述声明者,本网将追究其相关法律责任。如其他媒体、网站或个人转载使用,请联系本网站丁先生:news@time-weekly.com